Zonglin Lyu bio photo

Email

Twitter

Github

Google Scholar

Peer-reviewed Publications

*: equal contribution, ✉️: corresponding author

2026
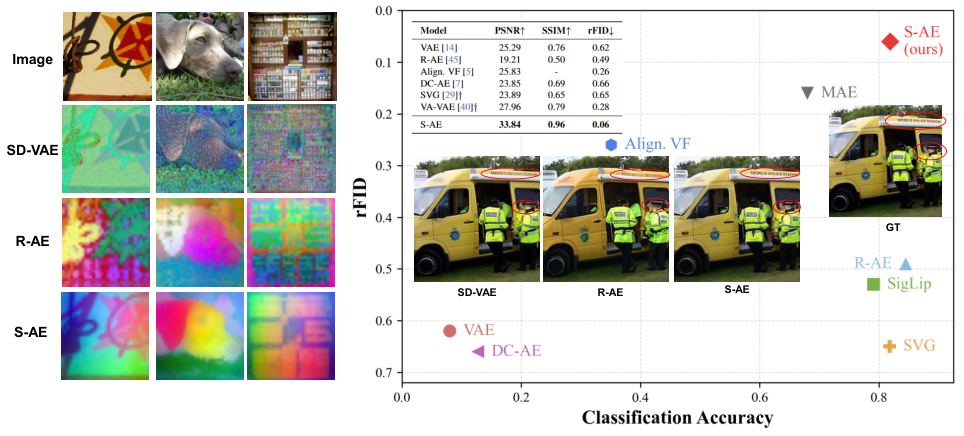

Semantic Auto-encoder overview Unified Latent Space for Understanding and Generation via Semantic Auto-encoder
Xiaojie Li, Yang Zhao, Ming Li, Yancheng Zhang, Zonglin Lyu, Yunpeng Chen, Rui Wang, Daquan Zhou.
CVPR 2026
[Paper]
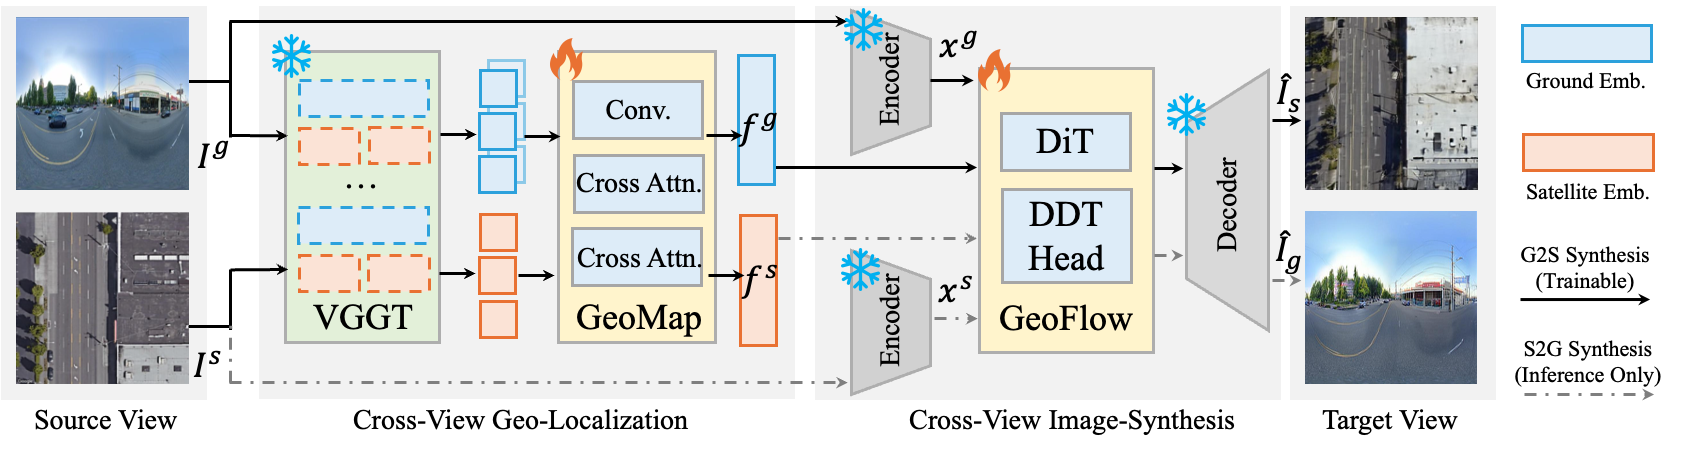
Geo² cross-view localization and image synthesis overview Geo²: Geometry-Guided Cross-view Geo-Localization and Image Synthesis
Yancheng Zhang, Xiaohan Zhang, Guangyu Sun, Zonglin Lyu, Safwan Wshah, Chen Chen.
CVPR 2026
[Paper] [Code] [Webpage]
Learning from noisy preferences overview Learning from Noisy Preferences: A Semi-Supervised Learning Approach to Direct Preference Optimization
Xinxin Liu, Ming Li, Zonglin Lyu, Yuzhang Shang, Chen Chen✉️.
ICLR 2026
[Paper] [Webpage]

2025


Condition Preference Optimization overview CPO: Condition Preference Optimization for Controllable Image Generation
Zonglin Lyu, Ming Li, Xinxin Liu, Chen Chen✉️.
NeurIPS 2025
[Paper] [Code] [Webpage]
Temporal-aware latent Brownian bridge video interpolation overview TLB-VFI: Temporal-Aware Latent Brownian Bridge Diffusion for Video Frame Interpolation
Zonglin Lyu, Chen Chen✉️.
ICCV 2025
[Paper] [Code] [Webpage]

2024


Consecutive Brownian bridge frame interpolation overview Frame Interpolation with Consecutive Brownian Bridge Diffusion
Zonglin Lyu, Ming Li, Jianbo Jiao, Chen Chen✉️.
ACM MM 2024
[Paper] [Code] [Webpage]
Open MARS self-driving dataset overview Multiagent Multitraversal Multimodal Self-Driving: Open MARS Dataset
Yiming Li*, Zhiheng Li*, Nuo Chen*, Moonjun Gong*, Zonglin Lyu*, Zehong Wang, Peili Jiang, Chen Feng✉️.
CVPR 2024
[Paper] [Code] [Webpage]

2022


Parallel series embedding for time series forecasting overview How Features Benefit: Parallel Series Embedding for Multivariate Time Series Forecasting with Transformer
Xuande Feng*, Zonglin Lyu*✉️.
ICTAI 2022 (oral presentation)
[Paper] [Code]

Preprints

*: equal contribution, ✉️: corresponding author

2024


Multimodal language models for place recognition overview Tell Me Where You Are: Multimodal LLMs Meet Place Recognition
Zonglin Lyu, Juexiao Zhang, Mingxuan Lu, Yiming Li, Chen Feng✉️.
arXiv 2024
[Paper] [Code] [Webpage]

2023


Collaborative visual place recognition overview Collaborative Visual Place Recognition
Yiming Li*, Zonglin Lyu*, Mingxuan Lu, Chao Chen, Michael Milford, Chen Feng✉️.
arXiv 2023
[Paper] [Code] [Webpage]